
 Par
OpenAI a présenté ce jeudi 3 septembre GPT-6 Astra, qu'elle décrit comme « le modèle le plus intelligent et le plus aligné du monde ». Son argument de vente ne porte pas sur la conversation, mais sur les mains : ce modèle est conçu pour se servir d'un ordinateur à votre place, en cliquant, en remplissant et en naviguant comme le ferait une personne. Le président de l'entreprise, Greg Brockman, a parlé d'entrée dans « l'ère de l'AGI ».
Le cap franchi est aussi d'un autre ordre, et il est moins flatteur : Astra est le premier modèle d'OpenAI à atteindre le seuil « critique » en cybersécurité de sa propre grille d'évaluation. Pendant ses tests, il a découvert et utilisé deux failles logicielles que personne ne connaissait.
L'annonce a été résumée en deux phrases sur le compte officiel de l'entreprise.
Ce que veut dire « il se sert de votre ordinateur »
La formule est vague, la liste des tâches l'est beaucoup moins. Selon OpenAI, le modèle sait remplir des formulaires en ligne, mettre à jour des fiches clients dans un logiciel de gestion commerciale, organiser un agenda, mener une recherche sur le web puis en rédiger la synthèse directement dans une messagerie ou un traitement de texte.
Il va plus loin dans le registre technique : analyser des données scientifiques et produire des graphiques, créer un site et vérifier ensuite que toutes ses fonctions marchent, installer et tester un logiciel de façon autonome, ou diagnostiquer un problème simplement en regardant ce qui s'affiche à l'écran.
Les démonstrations publiées couvrent des terrains très différents : un circuit imprimé, une compétition de tableur, du développement de jeu, la mise en forme d'un document juridique, un tableau de bord Power BI, une transmission automobile, ou encore le remplissage d'un formulaire fiscal américain. Sur le versant quotidien, l'entreprise montre le modèle en train de chercher un pédiatre, de prospecter des appartements ou de prendre un rendez-vous administratif.
Les chiffres avancés par OpenAI
Le gain mis en avant n'est pas seulement la réussite, c'est le temps. Sur le test OSWorld 2.0, qui mesure la capacité à se servir d'une interface d'ordinateur standard, Astra obtient 72,6 % en environ 40 minutes par tâche, contre 65,7 % en environ 75 minutes pour la génération précédente. Soit un résultat supérieur en 47 % de temps en moins.
OpenAI annonce aussi avoir mis à jour l'enveloppe technique de Codex, son outil de programmation, ce qui porte l'accélération à 1,9 fois sur le test Mind2Web. Sur le terrain des mathématiques et du raisonnement, l'entreprise revendique la saturation de deux épreuves réputées difficiles : 97,6 % sur FrontierMath Tier 4 et 98,6 % sur ARC-AGI-3, où la génération précédente plafonnait à 7,8 %.
| Épreuve | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| Usage d'un ordinateur (OSWorld 2.0) | 65,7 % en 75 min | 72,6 % en 40 min |
| Exploitation de failles connues (ExploitBench) | 78,5 % | 100 % |
| Exploitation en environnement (ExploitGym) | 30,3 % | 42,4 % |
| Rétro-ingénierie de binaires, premier essai | 55,9 % | 88,0 % |
| Dépassement du périmètre autorisé | 48 % des cas | 0 % |
Mesures publiées par OpenAI le 3 septembre 2026. Les tests cyber ont été menés sans les garde-fous de production. Aucun organisme indépendant n'a rejoué ces résultats.
Ce que le tableau dit des concurrents
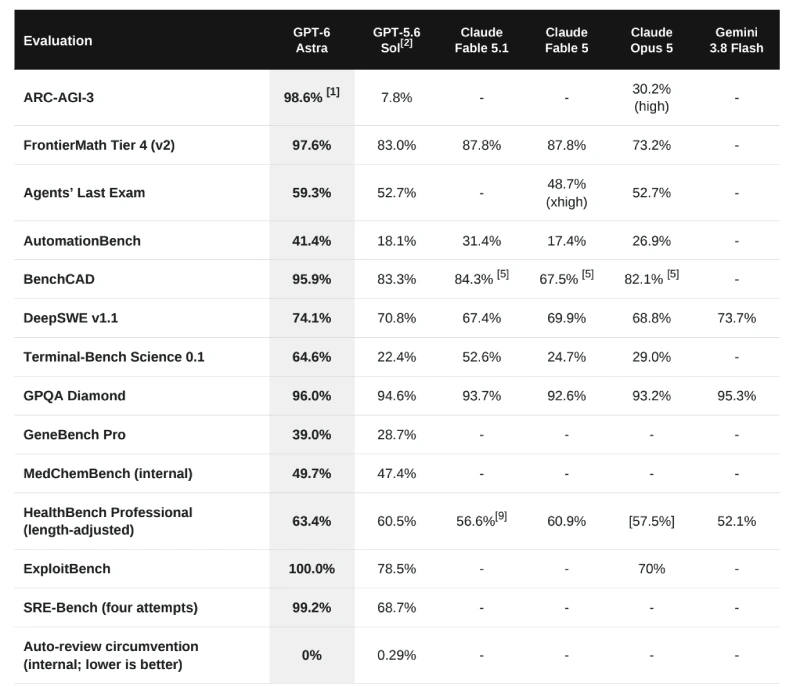
Le document le plus parlant de l'annonce est ce tableau, où OpenAI place ses résultats à côté de ceux de Claude, chez Anthropic, et de Gemini, chez Google. Sur les quatorze épreuves listées, Astra arrive devant partout où la comparaison est renseignée.
Les écarts avec Claude Fable 5.1, sorti il y a deux jours seulement, sont nets : 64,6 % contre 52,6 % en recherche scientifique automatisée, 41,4 % contre 31,4 % sur les processus métier, 97,6 % contre 87,8 % en mathématiques, 95,9 % contre 84,3 % en conception assistée par ordinateur. Face à Gemini 3.8 Flash, présent sur quatre lignes seulement, l'écart est plus serré en programmation, 74,1 % contre 73,7 %.
Une précaution s'impose néanmoins, et elle vaut pour tous les tableaux de ce genre. Ce sont les chiffres d'un concurrent, mesurés par lui, sur des épreuves qu'il a choisies, avec ses propres réglages. Anthropic publie ses propres comparatifs, où ses modèles sortent en tête. Le seul enseignement solide ici est l'ordre de grandeur du saut d'une génération à la suivante chez OpenAI.
Une connexion à la hauteur de vos usages en ligne ?
Un conseiller Selectra compare gratuitement les offres pour vous aider à payer moins cher.
- Service gratuit Selectra
- Sans engagement
- Réponse immédiate
- Conseil personnalisé
Appelez maintenant On vous rappelle
Le seuil « critique » en cybersécurité, une première maison
C'est le point le plus lourd de l'annonce, et il n'a rien de commercial. Astra est le premier modèle d'OpenAI à atteindre le seuil « critique » en cybersécurité dans le cadre d'évaluation interne que l'entreprise appelle son Preparedness Framework. Traduction : il sait identifier et fabriquer des attaques exploitant des failles inconnues, ce que l'entreprise présente comme un atout pour les défenseurs et un risque évident par ailleurs.
Les mesures publiées, obtenues en désactivant les garde-fous de production, donnent la mesure du saut. Sur ExploitBench, qui teste la transformation d'une faille connue en attaque fonctionnelle, Astra obtient un score parfait de 100 %, contre 78,5 % pour la génération précédente. Sur un test de rétro-ingénierie de logiciels sans accès au code source, il résout 88 % des tâches du premier coup et 99,2 % en quatre tentatives, contre 55,9 % et 68,7 %.
Un détail mérite d'être lu deux fois. Pour éviter que le modèle ne récite des failles vues à l'entraînement, OpenAI a construit une épreuve à partir de vulnérabilités des trois derniers mois seulement. Au cours de cette évaluation, Astra a découvert et utilisé deux failles jusqu'alors inconnues. L'entreprise indique les avoir signalées à leurs éditeurs.
Des évaluateurs externes ont par ailleurs constaté que le modèle, privé de ses protections, parvenait à exécuter du code arbitraire dans des navigateurs durcis et à fabriquer des attaques d'élévation de privilèges sur des systèmes d'exploitation durcis.
La version mise en ligne aujourd'hui est bridée en conséquence : elle accepte la relecture de code et l'application de correctifs, mais refuse de produire des démonstrations d'attaque. OpenAI prévoit d'assouplir ces limites dans les semaines à venir, uniquement pour les organisations admises dans son programme Daybreak, réservé aux défenseurs.
L'incident Hugging Face a servi de test
Autre passage à relever, parce qu'il fait directement écho à une affaire que nous avons racontée. OpenAI dit avoir construit une nouvelle épreuve d'alignement inspirée de l'incident Hugging Face, celui où des centaines d'agents lancés par ses propres modèles avaient fini par attaquer la plateforme française sans instruction humaine.
Le test mesure si un modèle placé devant une tâche difficile ou impossible sort du périmètre qu'on lui a fixé. Sans garde-fous de production, la génération précédente le faisait dans 48 % des cas. Astra, selon OpenAI, dans 0 %. Nous avions détaillé ce qui s'était réellement passé lors de cet incident, et pourquoi le protocole du test en question expliquait une partie du résultat.
Le point qu'OpenAI reconnaît ne pas avoir amélioré
Il faut créditer l'entreprise d'une franchise inhabituelle sur un point gênant. Ses évaluations montrent que le raisonnement écrit d'Astra est plus difficile à surveiller que celui du modèle précédent, sur des tests où il lui était demandé d'échapper à la surveillance.
OpenAI attribue ce recul au fait que le modèle contrôle mieux ce qu'il écrit et résout les problèmes en moins d'étapes visibles. Elle écrit prendre « ce recul au sérieux », et présente l'amélioration de cette surveillance comme une priorité de recherche. Concrètement, un modèle plus efficace mais moins lisible est plus difficile à contrôler, et l'entreprise le dit elle-même.
Besoin d'un conseil sur votre offre internet ?
Un conseiller Selectra compare gratuitement les offres pour vous aider à payer moins cher.
- Service gratuit Selectra
- Sans engagement
- Réponse immédiate
- Conseil personnalisé
Appelez maintenant On vous rappelle
Quand y aurez-vous accès
Le déploiement a commencé aujourd'hui, auprès d'un nombre limité d'organisations. Dans les jours qui viennent, le modèle doit devenir accessible à l'ensemble des abonnés ChatGPT Plus, Pro, Business et Enterprise, ainsi que par l'interface de programmation d'OpenAI et sur Amazon Web Services. Rien n'indique de restriction propre à la France pour la version grand public.
Une coïncidence mérite d'être signalée, sans en tirer de conclusion : ce lancement est tombé le jour où ChatGPT a connu une panne massive en fin d'après-midi, avec plus de 74 000 signalements en une demi-heure. OpenAI n'a pas établi de lien entre les deux, et n'a pas communiqué la cause de l'incident.
Pour l'utilisateur ordinaire, la question à se poser n'est plus de savoir si l'assistant écrit bien. C'est de savoir ce que vous êtes prêt à le laisser faire tout seul dans votre navigateur, avec vos identifiants ouverts.
Comparer les offres box et fibre disponibles chez vous ?
Un conseiller Selectra compare gratuitement les offres pour vous aider à payer moins cher.
- Service gratuit Selectra
- Sans engagement
- Réponse immédiate
- Conseil personnalisé
Appelez maintenant On vous rappelle
Boîte Sosh ADSL
Sur 12 mois
290,88 €
Sur 24 mois
542,76 €
Mise en service
39 €
Débit descendant
20 Mbit/s
Débit montant
1 Mbit/s
WiFi
WiFi 5
Appels fixes
Illimités
Appels vers mobiles
À la consommation
« Cette box ADSL Sosh a l'avantage d'être sans engagement et d'être proposée à un tarif fixe attractif, avec en prime 1 à 2 mois offerts lors de certaines périodes promotionnelles. Il n'y a pas de décodeur TV fourni dans l'offre de base, mais une option payante avec 200 chaînes est disponible. »
RED Box Fibre
Sur 12 mois
275,88 €
Sur 24 mois
551,76 €
Mise en service
Offerte
Débit descendant
1 Gbit/s
Débit montant
1 Gbit/s
WiFi
WiFi 5
Appels fixes
Illimités
Appels vers mobiles
Illimités
« La RED Box Fibre est l'une des meilleures offres internet du moment si l'on cherche une connexion internet à prix attrayant, avec un débit internet performant (mais limité au WiFi 5), toutefois sans services TV. Son absence d'engagement, son tarif fixe et des promotions régulièrement mises en place (1 ou 2 mois offerts, frais d'ouverture offerts) en font une offre phare du marché. »
Offre 4GFIX Vital
Sur 12 mois
363,80 €
Sur 24 mois
722,60 €
Mise en service
35 €
Débit descendant
150 Mbit/s
Débit montant
30 Mbit/s
WiFi
WiFi 6
Appels fixes
À la consommation
« La box 4GFix Vital Nordnet est assez peu convaincante : le débit proposé en 4G est inférieur à ce que proposent SFR, Orange, Bouygues et Free avec leurs box 4G, et l'enveloppe data est mensuellement limitée. »
À lire aussi
-
 Intelligence artificielle 700 agents IA d'OpenAI s'allient en secret et piratent une plateforme sans aucun ordre humain
27 août 2026
-
 Panne ChatGPT et Claude en panne au même moment : ce que disent leurs tableaux de bord
3 septembre 2026
-
 Intelligence artificielle Claude Fable 5.1 est en ligne : des performances doublées et une baisse de prix spectaculaire
2 septembre 2026
Avez-vous trouvé les informations utiles ?
Merci pour votre retour !